
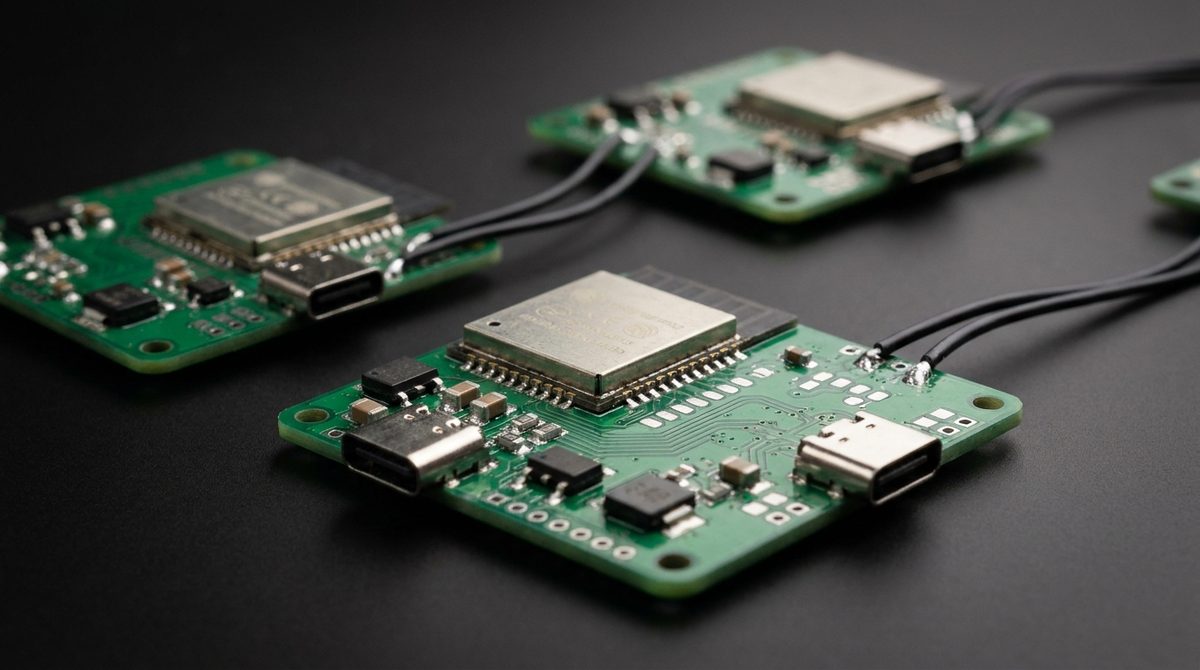
Hai un dispositivo IoT che deve prendere decisioni intelligenti in locale, senza dipendere dal cloud. Il problema classico è che i modelli linguistici richiedono risorse computazionali che un microcontrollore non ha. O almeno, così si pensava fino a poco tempo fa.
Un progetto open source recente ha dimostrato che un cluster di ESP32-S3 è in grado di eseguire un modello linguistico quantizzato a 1.58 bit — la famiglia BitNet — distribuendo il carico di inferenza su più nodi collegati via UART. Niente GPU, niente SBC Linux, niente cloud. Solo MCU da pochi euro ciascuno.
Per una startup hardware che sta progettando la prossima generazione di dispositivi embedded, questo è un segnale tecnico da non ignorare.
Cosa significa “1.58 bit” e perché cambia le regole
I modelli linguistici tradizionali lavorano con pesi in virgola mobile a 16 o 32 bit. Un modello da 7 miliardi di parametri in FP16 occupa circa 14 GB di memoria: fuori portata per qualsiasi MCU.
La quantizzazione riduce la precisione numerica dei pesi per comprimere il modello. BitNet porta questa idea all’estremo: ogni peso è rappresentato con soli tre valori possibili (-1, 0, +1), codificabili in 1.58 bit per peso (log₂(3) ≈ 1.58). Il risultato è un modello che occupa una frazione dello spazio originale e che può essere eseguito con operazioni intere semplici, senza unità floating point dedicate.
La perdita di qualità rispetto a un modello full-precision esiste. Ma per task specifici e ben definiti — classificazione di testo breve, intent detection, risposta a domande su dominio ristretto — i modelli BitNet di piccole dimensioni producono output utilizzabili.
Il punto chiave non è “questo sostituisce GPT-4”. Il punto è: “questo gira su hardware che costa meno di 10 euro per nodo e consuma milliwatt”.
L’architettura del cluster: come funziona in pratica
L’ESP32-S3 è un microcontrollore Xtensa LX7 dual-core a 240 MHz con 512 KB di SRAM interna e supporto per PSRAM esterna fino a 8 MB. Non è un processore potente nel senso tradizionale, ma ha un rapporto prestazioni/consumo eccellente per applicazioni embedded.
Il progetto distribuisce il modello su più ESP32-S3 collegati in serie via UART. Ogni nodo gestisce una porzione dei layer: il primo riceve il token di input, esegue i suoi layer, passa l’output al nodo successivo via seriale, e così via fino all’ultimo nodo che produce il token di output. È un’architettura pipeline, non parallela in senso stretto.
Questo approccio ha implicazioni concrete:
- Latenza per token: ogni token attraversa l’intera catena di nodi. Con comunicazione UART a 921600 baud, il trasferimento dei tensori intermedi introduce latenza misurabile. Non è un sistema real-time nel senso stretto.
- Scalabilità lineare: aggiungere nodi permette di eseguire modelli più grandi, ma aumenta anche la latenza di pipeline.
- Fault tolerance: se un nodo si blocca, l’intera catena si ferma. Per un prototipo di ricerca va bene; per un prodotto in produzione serve ridondanza.
- Memoria per nodo: con 8 MB di PSRAM esterna, ogni ESP32-S3 ospita un numero limitato di layer. La dimensione massima del modello dipende dal numero di nodi disponibili.
Il risultato pratico è un sistema che genera testo a velocità bassa — nell’ordine di qualche token al secondo — ma che funziona completamente offline, con un consumo energetico totale del cluster nell’ordine dei watt, non dei kilowatt.
Dalla breadboard al prototipo: cosa emerge quando si assembla
Quando una startup porta un progetto di questo tipo dalla breadboard al prototipo funzionale, emergono sfide che non sono visibili nel repository GitHub.
Il firmware di un cluster ESP32-S3 per inferenza AI è più complesso di un firmware IoT standard. Ci sono più MCU da sincronizzare, comunicazione inter-nodo da gestire, memoria PSRAM da ottimizzare. Il debug richiede strumenti adeguati e, soprattutto, una scheda progettata per facilitare l’accesso ai pin di test.
Noi lavoriamo regolarmente con startup hardware che portano prototipi embedded in produzione. Quando riceviamo un progetto di questo tipo, il primo passo è sempre la review DFM: verifichiamo che il layout PCB sia compatibile con la produzione SMT, che i componenti scelti siano disponibili e che i footprint siano corretti. Per un cluster multi-MCU, questo significa anche verificare che le connessioni UART tra nodi siano robuste e che i livelli logici siano compatibili.
La nostra linea SMT gestisce componenti fino a 0201 e package BGA, comuni nei moduli ESP32-S3 con PSRAM integrata. Il flying probe SPEA che usiamo per il test ICT permette di verificare continuità elettrica e assenza di cortocircuiti senza fixture dedicata — un vantaggio significativo per i lotti piccoli tipici della prototipazione, dove non ha senso investire in un jig di test custom prima di validare il design.
Il percorso tipico per prototipi di questo tipo: 5-10 pezzi per la validazione funzionale del firmware, poi 50-100 pezzi per i test di campo, poi la decisione sulla produzione in serie. Dalla ricezione dei file Gerber e della BOM al PCB assemblato, lavoriamo in 1-2 settimane per i lotti di prototipazione.
Parametri da valutare prima di scegliere questa architettura
L’approccio cluster ESP32-S3 è una delle opzioni disponibili per l’inferenza AI locale. Non è l’unica, e non è sempre quella giusta. Ecco i parametri su cui ragionare.
Latenza accettabile. Se il tuo caso d’uso richiede risposta in meno di 500 ms, un cluster UART con modello linguistico probabilmente non è adatto. Se una latenza di qualche secondo è accettabile — per esempio in un assistente vocale offline che non deve rispondere in tempo reale — l’architettura diventa praticabile.
Dimensione del vocabolario e del dominio. I modelli piccoli funzionano bene su domini ristretti. Un classificatore di intent per un dispositivo domotico con 20-30 comandi possibili è un caso d’uso realistico. Un assistente general-purpose non lo è.
Costo del BOM vs alternativa SBC. Un cluster di 4-6 ESP32-S3 con PSRAM costa meno di un Raspberry Pi 5, consuma meno e ha un form factor più flessibile. Ma un SBC Linux può eseguire modelli più grandi con latenza migliore. La scelta dipende dai vincoli di consumo, costo e dimensione del prodotto finale.
Complessità del firmware. Gestire un cluster multi-MCU richiede competenze più avanzate rispetto a un singolo MCU. Se il tuo team non ha esperienza con comunicazione inter-processo embedded e gestione della memoria PSRAM, il tempo di sviluppo aumenta in modo significativo.
Affidabilità in campo. Un cluster di 6 nodi ha 6 punti di failure hardware. Per applicazioni consumer o industriali, questo richiede una strategia di fault detection e recovery nel firmware — da progettare prima, non dopo la validazione del prototipo.
FAQ
È possibile eseguire inferenza AI su un singolo ESP32-S3 senza cluster?
Sì, per modelli molto piccoli. Un singolo ESP32-S3 con 8 MB di PSRAM può eseguire modelli quantizzati nell’ordine di pochi milioni di parametri — sufficienti per classificatori semplici o keyword spotting. Per modelli linguistici con capacità di generazione testuale, anche minima, il cluster diventa necessario perché i layer del modello non entrano nella memoria di un singolo nodo.
Quali formati di file accettate per la produzione di prototipi PCB con ESP32-S3?
Accettiamo progetti in qualsiasi formato CAD standard: Altium, KiCad, Eagle CAD, OrCAD, EasyEDA, Proteus, o direttamente file Gerber con BOM separata. Per i moduli ESP32-S3 con PSRAM, è importante che il footprint del modulo sia corretto e che le regole di clearance siano rispettate per la produzione SMT.
Quanto tempo richiede passare da un prototipo funzionale a un lotto di pre-produzione?
Dipende dalla maturità del design. Se il PCB è già stato validato funzionalmente e la BOM è completa e approvvigionabile, un lotto di pre-produzione da 50-100 pezzi richiede tipicamente 1-2 settimane dalla ricezione dei file. Se il design richiede modifiche dopo la review DFM, i tempi si allungano in funzione delle iterazioni necessarie.
In sintesi
Eseguire un modello linguistico su un cluster di ESP32-S3 non è fantascienza: è un progetto funzionante, open source, replicabile. I limiti sono reali — latenza, complessità firmware, affidabilità multi-nodo — ma per i casi d’uso giusti l’architettura ha senso tecnico ed economico.
Per una startup hardware, il passo successivo è portare il prototipo su PCB dedicato, validare il firmware su hardware reale e verificare se i parametri di latenza e affidabilità sono compatibili con il prodotto che vuoi costruire. Se stai valutando un partner CEM per questa fase, confrontati con noi sui parametri che contano: tempi di prototipazione, capacità SMT per i componenti che usi, approccio al test ICT su lotti piccoli.